Dans la Partie 2, nous avons exploré comment Product Loop aide notre équipe GoDaddy Airo AI Builder à trouver et diagnostiquer les problèmes clients. Cet article examine une autre utilisation des mêmes signaux de production : enrichir nos jeux de données d'évaluation d'agents IA avec des scénarios tirés de la façon dont les clients utilisent réellement Airo.
Si vous êtes nouveau dans la série, la Partie 1 explique pourquoi les produits agentiques brisent la mesure traditionnelle. L'unité significative est la boucle complète de l'intention à la correction jusqu'au résultat, pas un seul tour de chat.
Conclusion clé : Les évaluations basées sur les spécifications définissent le comportement attendu. Les patterns de conversation de production révèlent comment les clients formulent réellement leurs demandes, combinent les étapes et font référence aux tours précédents — transformant les vrais workflows en tests de régression et une couverture d'évaluation plus profonde.
Dans cet article
- Que sont les jeux de données d'évaluation d'agents IA ?
- Commencer par la spécification, puis apprendre de l'usage
- Exercices de manuel et conversations quotidiennes
- Transformer les interactions clients en scénarios d'évaluation
- Apprendre des échecs
- Protéger les workflows que les clients utilisent le plus
- Protéger la confidentialité des clients
- Ce que cela change pour nous chez GoDaddy
- Série Product Loop
- Questions fréquentes
Que sont les jeux de données d'évaluation d'agents IA ?
Les jeux de données d'évaluation d'agents IA sont des collections structurées de scénarios de test utilisés pour vérifier si un agent IA se comporte comme prévu sur une gamme de tâches du monde réel. Chaque scénario comprend généralement un état initial du produit, une séquence de demandes utilisateur et une définition claire de ce à quoi ressemble un résultat réussi.
Contrairement aux benchmarks à un seul tour, les jeux de données d'évaluation d'agents doivent tenir compte des conversations multi-tours, du contexte porté à travers les étapes et de l'écart entre ce qu'un utilisateur dit et ce qu'il veut dire. Pour les produits agentiques comme GoDaddy Airo AI Builder, un jeu de données d'évaluation robuste est le mécanisme principal pour détecter les régressions avant qu'elles n'atteignent les clients.
Commencer par la spécification, puis apprendre de l'usage
Notre jeu de données d'évaluation initial commence par les spécifications du produit : ce qu'une fonctionnalité doit faire et à quoi ressemble un résultat réussi. Ces exigences nous donnent une base délibérée pour tester le produit avant que les clients ne l'utilisent.
Les évaluations basées sur les spécifications restent essentielles après le lancement. Elles définissent le comportement que nous attendons et fournissent un moyen cohérent de le vérifier à mesure que le produit évolue. L'usage en production ajoute une autre perspective : comment les clients expriment leurs objectifs, combinent les demandes et répondent à l'agent en cours de route.
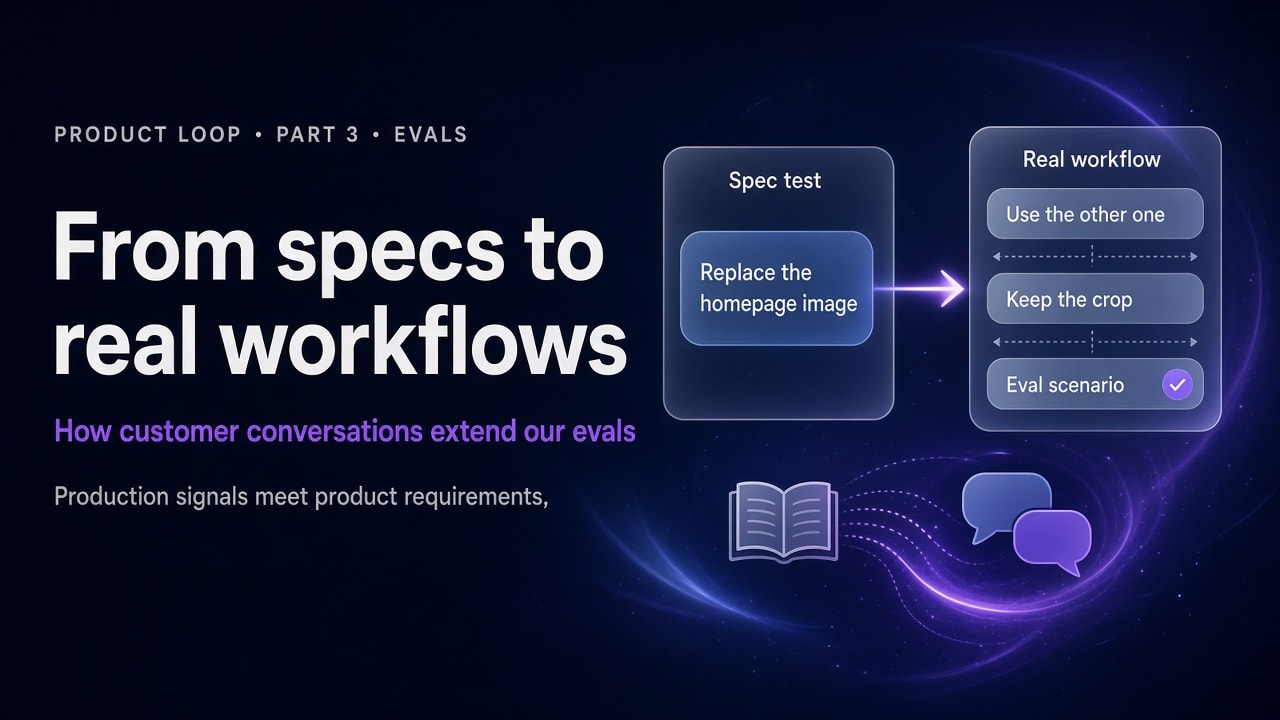
Cette distinction compte pour GoDaddy Airo AI Builder. Par exemple, une spec peut définir ce que signifie remplacer une image correctement. Les conversations clients révèlent de nombreuses façons dont les gens demandent ce changement, y compris des références à des messages précédents, des ajustements de suivi et des détails qu'ils s'attendent à ce que l'agent se souvienne.
Product Loop nous aide à intégrer ces patterns dans notre jeu de données d'évaluation. Il étend la couverture que nous construisons à partir des spécifications. Il ne remplace pas cette base.
Exercices de manuel et conversations quotidiennes
Pensez à l'apprentissage d'une langue. Les exercices de manuel enseignent le vocabulaire, la grammaire et comment construire une phrase. Écouter des conversations quotidiennes ajoute de la pratique sur la façon dont les gens utilisent ces compétences dans différentes situations. Les deux ont un but.
Un manuel pourrait apprendre à quelqu'un à commander un café en disant : « Je voudrais un grand café glacé, s'il vous plaît. » Dans un café familier, il pourrait dire : « La même chose qu'hier, mais glacé », puis changer la taille. Comprendre cette demande dépend de savoir ce qui s'est passé avant.
Les clients utilisent Airo de la même façon. Un test pourrait demander : « Remplace l'image de la page d'accueil. » Un client pourrait plutôt dire : « Utilise l'autre », suivi de : « Garde le recadrage comme il était. » Airo doit comprendre quelle image ils veulent dire et quels choix précédents doivent rester les mêmes.
Nous pouvons concevoir des tests pour le contexte conversationnel dès le départ. Product Loop ajoute des preuves sur les patterns spécifiques que les clients utilisent, nous aidant à étendre ces tests et à décider où une couverture plus profonde serait la plus précieuse. Cela s'appuie sur le cadre de mesure multi-tours de la Partie 1 : une réponse n'est pas la même chose qu'un résultat.
Transformer les interactions clients en scénarios d'évaluation
Product Loop lit les conversations clients aux côtés de la télémétrie et du contexte produit. Il peut regrouper les interactions par ce que les clients essaient d'accomplir, puis identifier les façons courantes dont ils formulent une demande et les étapes qui suivent.
L'unité utile est souvent une séquence, pas un seul prompt. « Utilise l'autre » a peu de sens sans les choix d'image précédents. Un scénario significatif a besoin de la conversation pertinente et de l'état initial du produit, suivi de la demande du client et d'une définition claire du résultat attendu.
Cette dernière partie compte. Une conversation de production nous dit ce qui s'est passé. Elle ne nous dit pas automatiquement ce qui aurait dû se passer. Le résultat attendu doit encore être vérifié par rapport aux exigences du produit et à l'intention du client. Pour l'édition d'images, que l'agent dise « Fait » ne suffit pas. La page résultante doit refléter le changement demandé.
Product Loop peut générer des scénarios candidats à partir de ces patterns et créer des tickets pour les lacunes de couverture. Avant qu'un candidat devienne un test réutilisable, il a besoin d'une configuration révisable, d'un critère de succès clair et d'un traitement approprié des données clients. Les détails privés doivent être supprimés ou remplacés sans perdre le contexte qui rend le scénario utile.
Cela connecte ce que nous apprenons en production au travail d'évaluation concret, plutôt que de laisser les résultats dans un rapport. C'est l'équivalent évals du flux de travail de diagnostic de la Partie 2, où les signaux de production alimentent des tickets d'ingénierie plutôt que des cas de test.
Apprendre des échecs
Une utilisation est de transformer un échec récurrent en un test de régression : un test conçu pour détecter si un problème précédemment corrigé revient.
Supposons que les clients aient régulièrement besoin de corriger un remplacement d'image parce qu'un paramètre de recadrage précédent est perdu. Product Loop peut identifier ce pattern et générer un scénario candidat qui préserve la séquence pertinente de demandes. L'équipe peut alors vérifier que le test reproduit le problème et que son résultat attendu correspond au comportement prévu.
Une fois le problème corrigé, ce scénario fournit une vérification répétable pour les changements futurs. Il ne garantit pas que le problème ne peut jamais revenir, mais il nous donne un moyen ciblé de détecter une récurrence avant qu'une version n'atteigne les clients.
La valeur est que l'investigation contribue à la fois à un correctif et à un ajout durable à notre couverture d'évaluation.
Protéger les workflows que les clients utilisent le plus
Les échecs ne sont qu'une raison d'ajouter de la couverture. Product Loop nous aide aussi à comprendre sur quelles capacités les clients s'appuient et les variations qu'ils utilisent le plus souvent, même quand ces interactions réussissent.
Prenez l'édition d'images comme exemple. Notre jeu de données basé sur les spécifications peut couvrir les comportements d'édition définis. Si l'usage en production montre que l'édition d'images est particulièrement courante, Product Loop peut nous aider à approfondir cette couverture autour des vrais workflows : remplacer une image tout en préservant son recadrage, l'ajuster après avoir changé une mise en page, ou revenir à un choix précédent plus tard dans la conversation.
Ce sont des exemples illustratifs, mais le principe est pratique. Nous voulons protéger les combinaisons dont dépendent les clients, pas attendre que chacune échoue avant d'ajouter un test. À mesure que le comportement des clients évolue, Product Loop nous aide à identifier d'autres ajouts. L'objectif n'est pas de régénérer l'ensemble du jeu de données chaque jour. Un ensemble stable de tests reste précieux pour comparer les versions, tandis que les ajouts révisés maintiennent notre couverture connectée à l'usage actuel.
Protéger la confidentialité des clients
Protéger les informations des clients est une partie intégrante de la façon dont nous construisons des scénarios d'évaluation. Lors de la génération de scénarios, nous masquons les informations personnellement identifiables (PII) tout en préservant la formulation et le contexte pertinents nécessaires pour tester le comportement de l'agent. L'accent est mis sur la compréhension de la tâche du client, pas sur l'identification de la personne derrière elle.
Ce que cela change pour nous chez GoDaddy
Pour notre équipe Airo AI Builder, Product Loop connecte deux types de connaissances : ce que nous avons conçu le produit pour faire et comment les clients le mettent en pratique. Nos spécifications établissent le comportement attendu. Les patterns de production nous aident à voir où davantage de variations, de contexte de conversation ou de combinaisons de workflows méritent une couverture.
Cela donne à nos ingénieurs et à notre équipe produit une base plus claire pour décider où investir l'effort d'évaluation. Un problème récurrent peut mener à un test de régression ciblé. Une capacité très utilisée peut recevoir une couverture plus profonde avant qu'un échec n'attire notre attention. Les preuves viennent avec le travail proposé, réduisant l'effort nécessaire pour reconstruire chaque scénario.
C'est la direction que nous voulons donner à l'évaluation chez GoDaddy : une base solide dans les exigences du produit, étendue par ce que nous apprenons des clients. À mesure que les produits IA prennent en charge des workflows plus variés, les deux perspectives deviennent plus importantes, pas moins.
Dans le prochain et dernier article, nous explorerons comment Product Loop nous aide à identifier les capacités manquantes et les nouvelles opportunités de produit.
Série Product Loop
- Quand votre produit n'a plus un seul chemin : Mesurer les produits IA agentiques — pourquoi l'analyse d'entonnoir et la notation à un seul tour sont insuffisantes pour les produits agentiques
- Product Loop, Partie 2 : Trouver les bugs que personne n'a signalés — comment les signaux de production font remonter les problèmes clients récurrents
- Product Loop, Partie 3 : Enrichir nos évaluations avec de vrais workflows clients (cet article)
- Partie 4 (à venir) — capacités manquantes et nouvelles opportunités de produit
Questions fréquentes
Que sont les jeux de données d'évaluation d'agents IA ?
Les jeux de données d'évaluation d'agents IA sont des collections structurées de scénarios de test qui vérifient si un agent IA se comporte comme prévu. Pour les produits agentiques, chaque scénario comprend généralement un état initial du produit, une séquence de demandes utilisateur et un critère de succès clair — pas seulement un seul prompt et une réponse.
Pourquoi les évaluations basées sur les spécifications ne suffisent-elles pas après le lancement ?
Les specs définissent le comportement attendu, mais les clients formulent leurs objectifs de nombreuses façons, combinent les demandes et font référence aux tours précédents. L'usage en production révèle ces vrais patterns pour que le jeu de données d'évaluation reste aligné avec la façon dont les gens travaillent réellement.
Comment Product Loop transforme-t-il les conversations en scénarios d'évaluation ?
Product Loop regroupe les interactions de production par tâche, fait remonter les formulations courantes et les séquences d'étapes, et propose des scénarios candidats avec configuration et critères de succès. Chaque candidat est révisé, nettoyé des PII et vérifié par rapport aux exigences du produit avant de rejoindre le jeu de données réutilisable.
Qu'est-ce qu'un test de régression dans le contexte de l'évaluation d'agents IA ?
Un test de régression reproduit un échec précédemment corrigé pour que les versions futures puissent être vérifiées pour le même problème. Product Loop peut proposer ces tests à partir de patterns de correction récurrents dans les conversations clients.
Comment protégez-vous la confidentialité des clients lors de la construction de jeux de données d'évaluation ?
Les PII sont masquées ou remplacées lors de la génération de scénarios tout en préservant la formulation et le contexte nécessaires pour tester le comportement de l'agent. L'objectif est de préserver la structure de la tâche, pas d'identifier la personne derrière elle.
Prêt à voir la construction agentique en pratique ? Commencez à construire avec GoDaddy Airo AI Builder. Décrivez votre idée et regardez-la prendre vie. 50 crédits IA gratuits pour commencer.