En la Parte 2, exploramos cómo Product Loop ayuda a nuestro equipo de GoDaddy Airo AI Builder a encontrar y diagnosticar problemas de clientes. Esta publicación examina otro uso de las mismas señales de producción: ampliar nuestros conjuntos de datos de evaluación de agentes de IA con escenarios extraídos de cómo los clientes realmente usan Airo.
Si eres nuevo en la serie, la Parte 1 explica por qué los productos agénticos rompen la medición tradicional. La unidad significativa es el ciclo completo desde la intención hasta la corrección y el resultado, no un único turno de chat.
Conclusión clave: Las evaluaciones basadas en especificaciones definen el comportamiento esperado. Los patrones de conversación de producción revelan cómo los clientes realmente formulan solicitudes, combinan pasos y hacen referencia a turnos anteriores, convirtiendo los flujos de trabajo reales en pruebas de regresión y una cobertura de evaluación más profunda.
En este artículo
- ¿Qué son los conjuntos de datos de evaluación de agentes de IA?
- Empieza con la especificación, luego aprende del uso
- Ejercicios de libro de texto y conversaciones cotidianas
- Convertir interacciones de clientes en escenarios de evaluación
- Aprender de los fallos
- Proteger los flujos de trabajo que más usan los clientes
- Proteger la privacidad del cliente
- Qué cambia esto para nosotros en GoDaddy
- Serie Product Loop
- Preguntas frecuentes
¿Qué son los conjuntos de datos de evaluación de agentes de IA?
Los conjuntos de datos de evaluación de agentes de IA son colecciones estructuradas de escenarios de prueba utilizados para verificar si un agente de IA se comporta según lo previsto en una variedad de tareas del mundo real. Cada escenario típicamente incluye un estado inicial del producto, una secuencia de solicitudes del usuario y una definición clara de cómo se ve un resultado exitoso.
A diferencia de los benchmarks de un solo turno, los conjuntos de datos de evaluación de agentes deben tener en cuenta las conversaciones de múltiples turnos, el contexto llevado a través de los pasos y la brecha entre lo que un usuario dice y lo que quiere decir. Para productos agénticos como GoDaddy Airo AI Builder, un conjunto de datos de evaluación robusto es el mecanismo principal para detectar regresiones antes de que lleguen a los clientes.
Empieza con la especificación, luego aprende del uso
Nuestro conjunto de datos de evaluación inicial comienza con las especificaciones del producto: qué debe hacer una función y cómo se ve un resultado exitoso. Estos requisitos nos dan una base deliberada para probar el producto antes de que los clientes lo usen.
Las evaluaciones basadas en especificaciones siguen siendo esenciales después del lanzamiento. Definen el comportamiento que esperamos y proporcionan una forma consistente de verificarlo a medida que el producto cambia. El uso en producción añade otra perspectiva: cómo los clientes expresan sus objetivos, combinan solicitudes y responden al agente en el camino.
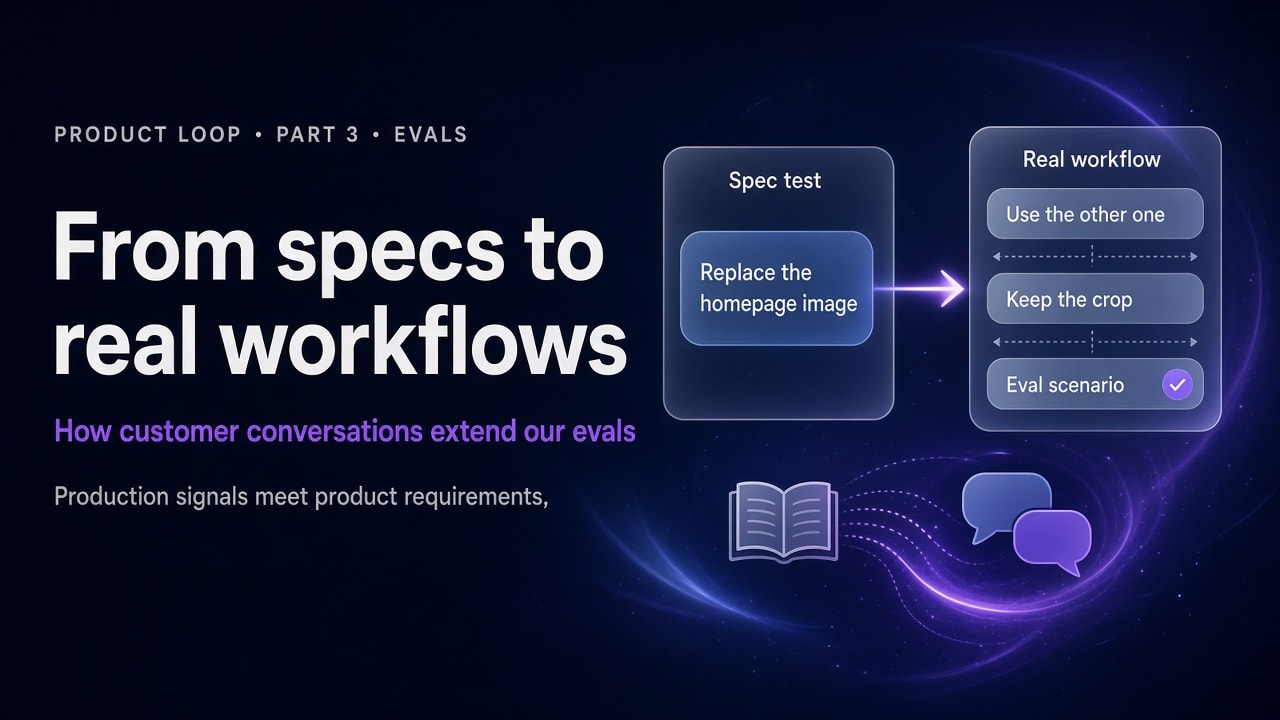
Esa distinción importa para GoDaddy Airo AI Builder. Por ejemplo, una especificación puede definir qué significa reemplazar una imagen correctamente. Las conversaciones con clientes revelan muchas formas en que las personas piden ese cambio, incluidas referencias a mensajes anteriores, ajustes de seguimiento y detalles que esperan que el agente recuerde.
Product Loop nos ayuda a incorporar esos patrones en nuestro conjunto de datos de evaluación. Amplía la cobertura que construimos a partir de las especificaciones. No reemplaza esa base.
Ejercicios de libro de texto y conversaciones cotidianas
Piensa en aprender un idioma. Los ejercicios del libro de texto enseñan vocabulario, gramática y cómo construir una oración. Escuchar conversaciones cotidianas añade práctica sobre cómo las personas usan esas habilidades en diferentes situaciones. Ambos tienen un propósito.
Un libro de texto podría enseñar a alguien a pedir café diciendo: "Me gustaría un café con hielo grande, por favor." En una cafetería familiar, podrían decir: "Lo mismo que ayer, pero con hielo", y luego cambiar el tamaño. Entender esa solicitud depende de saber qué vino antes.
Los clientes usan Airo de manera muy similar. Una prueba podría pedir: "Reemplaza la imagen de la página de inicio." Un cliente podría decir en cambio: "Usa la otra", seguido de: "Mantén el recorte como estaba." Airo necesita entender qué imagen quieren decir y qué elecciones anteriores deben mantenerse igual.
Podemos diseñar pruebas para el contexto conversacional desde el principio. Product Loop añade evidencia sobre los patrones específicos que usan los clientes, ayudándonos a ampliar esas pruebas y decidir dónde sería más valiosa una cobertura más profunda. Eso se basa en el marco de medición de múltiples turnos de la Parte 1: una respuesta no es lo mismo que un resultado.
Convertir interacciones de clientes en escenarios de evaluación
Product Loop lee las conversaciones de los clientes junto con la telemetría y el contexto del producto. Puede agrupar interacciones por lo que los clientes intentan lograr, luego identificar formas comunes en que formulan una solicitud y los pasos que siguen.
La unidad útil es a menudo una secuencia, no un único prompt. "Usa la otra" tiene poco sentido sin las elecciones de imagen anteriores. Un escenario significativo necesita la conversación relevante y el estado inicial del producto, seguido de la solicitud del cliente y una definición clara del resultado esperado.
Esa última parte importa. Una conversación de producción nos dice qué sucedió. No nos dice automáticamente qué debería haber sucedido. El resultado esperado aún necesita verificarse con los requisitos del producto y la intención del cliente. Para la edición de imágenes, que el agente diga "Listo" no es suficiente. La página resultante debe reflejar el cambio solicitado.
Product Loop puede generar escenarios candidatos a partir de estos patrones y crear tickets para brechas en la cobertura. Antes de que un candidato se convierta en una prueba reutilizable, necesita una configuración revisable, un criterio de éxito claro y el manejo apropiado de los datos del cliente. Los detalles privados deben eliminarse o reemplazarse sin perder el contexto que hace útil el escenario.
Esto conecta lo que aprendemos en producción con el trabajo de evaluación concreto, en lugar de dejar los hallazgos en un informe. Es el equivalente de evaluaciones al flujo de trabajo de diagnóstico de la Parte 2, donde las señales de producción alimentan tickets de ingeniería en lugar de casos de prueba.
Aprender de los fallos
Un uso es convertir un fallo recurrente en una prueba de regresión: una prueba diseñada para detectar si un problema previamente solucionado regresa.
Supongamos que los clientes necesitan repetidamente corregir un reemplazo de imagen porque se pierde una configuración de recorte anterior. Product Loop puede identificar ese patrón y generar un escenario candidato que preserve la secuencia relevante de solicitudes. El equipo puede entonces verificar que la prueba reproduce el problema y que su resultado esperado coincide con el comportamiento previsto.
Una vez solucionado el problema, ese escenario proporciona una verificación repetible para cambios futuros. No garantiza que el problema nunca pueda regresar, pero nos da una forma específica de detectar una recurrencia antes de que una versión llegue a los clientes.
El valor es que la investigación contribuye tanto a una solución como a una adición duradera a nuestra cobertura de evaluación.
Proteger los flujos de trabajo que más usan los clientes
Los fallos son solo una razón para añadir cobertura. Product Loop también nos ayuda a entender en qué capacidades confían los clientes y las variaciones que usan con más frecuencia, incluso cuando esas interacciones tienen éxito.
Toma la edición de imágenes como ejemplo. Nuestro conjunto de datos basado en especificaciones puede cubrir los comportamientos de edición definidos. Si el uso en producción muestra que la edición de imágenes es especialmente común, Product Loop puede ayudarnos a profundizar esa cobertura alrededor de los flujos de trabajo reales: reemplazar una imagen mientras se preserva su recorte, ajustarla después de cambiar un diseño, o volver a una elección anterior más tarde en la conversación.
Esos son ejemplos ilustrativos, pero el principio es práctico. Queremos proteger las combinaciones de las que dependen los clientes, no esperar a que cada una falle antes de añadir una prueba. A medida que cambia el comportamiento del cliente, Product Loop nos ayuda a identificar adiciones adicionales. El objetivo no es regenerar todo el conjunto de datos cada día. Un conjunto estable de pruebas sigue siendo valioso para comparar versiones, mientras que las adiciones revisadas mantienen nuestra cobertura conectada al uso actual.
Proteger la privacidad del cliente
Proteger la información del cliente es una parte integral de cómo construimos escenarios de evaluación. Durante la generación de escenarios, enmascaramos la información de identificación personal (PII) mientras preservamos la redacción y el contexto relevantes necesarios para probar el comportamiento del agente. El enfoque está en entender la tarea del cliente, no en identificar a la persona detrás de ella.
Qué cambia esto para nosotros en GoDaddy
Para nuestro equipo de Airo AI Builder, Product Loop conecta dos tipos de conocimiento: lo que diseñamos que hiciera el producto y cómo los clientes lo ponen en práctica. Nuestras especificaciones establecen el comportamiento esperado. Los patrones de producción nos ayudan a ver dónde merecen cobertura más variaciones, contexto de conversación o combinaciones de flujos de trabajo.
Esto le da a nuestros ingenieros y equipo de producto una base más clara para decidir dónde invertir el esfuerzo de evaluación. Un problema recurrente puede llevar a una prueba de regresión específica. Una capacidad muy utilizada puede recibir una cobertura más profunda antes de que un fallo llame nuestra atención. La evidencia viene con el trabajo propuesto, reduciendo el esfuerzo necesario para reconstruir cada escenario.
Esa es la dirección que queremos tomar la evaluación en GoDaddy: una base sólida en los requisitos del producto, ampliada por lo que aprendemos de los clientes. A medida que los productos de IA admiten flujos de trabajo más variados, ambas perspectivas se vuelven más importantes, no menos.
En el próximo y último artículo, exploraremos cómo Product Loop nos ayuda a identificar capacidades faltantes y nuevas oportunidades de producto.
Serie Product Loop
- Cuando tu producto deja de tener un único camino: Medir productos de IA agéntica — por qué el análisis de embudo y la puntuación de un solo turno se quedan cortos para los productos agénticos
- Product Loop, Parte 2: Encontrar los errores que nadie reportó — cómo las señales de producción detectan problemas recurrentes de clientes
- Product Loop, Parte 3: Ampliar nuestras evaluaciones con flujos de trabajo reales de clientes (este artículo)
- Parte 4 (próximamente) — capacidades faltantes y nuevas oportunidades de producto
Preguntas frecuentes
¿Qué son los conjuntos de datos de evaluación de agentes de IA?
Los conjuntos de datos de evaluación de agentes de IA son colecciones estructuradas de escenarios de prueba que verifican si un agente de IA se comporta según lo previsto. Para los productos agénticos, cada escenario típicamente incluye un estado inicial del producto, una secuencia de solicitudes del usuario y un criterio de éxito claro, no solo un único prompt y respuesta.
¿Por qué las evaluaciones basadas en especificaciones no son suficientes después del lanzamiento?
Las especificaciones definen el comportamiento esperado, pero los clientes formulan sus objetivos de muchas maneras, combinan solicitudes y hacen referencia a turnos anteriores. El uso en producción revela esos patrones reales para que el conjunto de datos de evaluación se mantenga alineado con cómo las personas realmente trabajan.
¿Cómo convierte Product Loop las conversaciones en escenarios de evaluación?
Product Loop agrupa las interacciones de producción por tarea, detecta formulaciones comunes y secuencias de pasos, y propone escenarios candidatos con configuración y criterios de éxito. Cada candidato se revisa, se elimina la PII y se verifica con los requisitos del producto antes de unirse al conjunto de datos reutilizable.
¿Qué es una prueba de regresión en el contexto de la evaluación de agentes de IA?
Una prueba de regresión reproduce un fallo previamente solucionado para que las versiones futuras puedan verificarse para el mismo problema. Product Loop puede proponer estas a partir de patrones de corrección recurrentes en las conversaciones de los clientes.
¿Cómo protegen la privacidad del cliente al construir conjuntos de datos de evaluación?
La PII se enmascara o reemplaza durante la generación de escenarios mientras se preserva la redacción y el contexto necesarios para probar el comportamiento del agente. El objetivo es preservar la estructura de la tarea, no identificar a la persona detrás de ella.
¿Listo para ver la construcción agéntica en práctica? Empieza a construir con GoDaddy Airo AI Builder. Describe tu idea y mírala cobrar vida. 50 créditos de IA gratuitos para empezar.